Fragen verstanden
Das Modell wählte die passende Abfrage.
WERKSTATT / TESTBERICHT
Lokale Modelle auf einem MacBook mit 48 GB RAM. Mit erfundenen Beispielen prüfen wir, wie gut sie Alltagsaufgaben lösen.
Neu vom 7. Oktober 2026: Kolibri, Kev und Gemma im grösseren lokalen Folio-Test →
24.09.2026 · 14 ERFUNDENE BEISPIELE
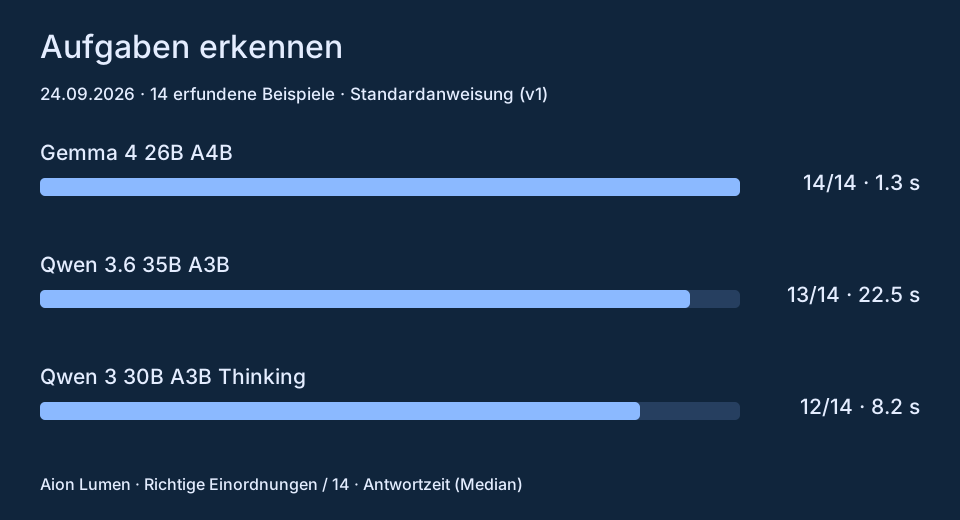
Drei Modelle ordnen dieselben Nachrichten ein: Aufgabe, unklar oder keine Aufgabe. Standardanweisung (v1).
Dieselben vierzehn Nachrichten haben wir zusätzlich mit einer präziseren Anweisung geprüft. Gemma lag bei beiden Varianten vorn.
| Modell | Anweisung | Richtig | Zeit · Median |
|---|---|---|---|
| Gemma 4 26B A4B | Standard (v1) | 14/14 | 1.3 s |
| Gemma 4 26B A4B | Präzisiert (v1-strict) | 14/14 | 1.3 s |
| Qwen 3.6 35B A3B | Standard (v1) | 13/14 | 22.5 s |
| Qwen 3.6 35B A3B | Präzisiert (v1-strict) | 12/14 | 23.2 s |
| Qwen 3 30B A3B Thinking | Standard (v1) | 12/14 | 8.2 s |
| Qwen 3 30B A3B Thinking | Präzisiert (v1-strict) | 13/14 | 9.2 s |
In Ledger versteht Qwen 3.8 die Frage. Code sucht die Buchungen heraus und berechnet die Antwort.
Das Modell wählte die passende Abfrage.
Der Weg von der Frage zur Antwort; neun Fälle nutzten das Modell.
Abfragen und Summen direkt im Code geprüft.
ENTWICKLUNG
August–September 2026
Zuerst haben wir lokale Modelle an Mails verglichen. Manche lieferten leere oder unlesbare Antworten. Für die Auswahl zählten Antwortqualität, Tempo und die Gegenprüfung von Hand.
22. September
Bei Ledger lernten wir, das Verstehen einer Frage und das Rechnen getrennt zu prüfen. Nach Verbesserungen erreichte der Ablauf die oben gezeigten Ergebnisse.
24. September
Drei Modelle probierten zwei Anweisungen. Dabei fiel auf: Unsere erwartete Antwort zu einer Besprechungsnotiz war falsch. Wir bewerteten die gespeicherten Antworten neu; diese Ergebnisse zeigen die Balken.
Heute
Antwortqualität, Tempo und menschliche Gegenprüfung bestimmen die Auswahl für die Mailverarbeitung. Der Katalog vereint zwölf Kandidaten aus verschiedenen Versuchen; die beiden Qwen-Versionen gehören zur selben Modellfamilie.
Der nächste sinnvolle Versuch: Gemma 4 26B an weiteren Mail-Grenzfällen und Werkzeugaufrufen prüfen.
← Zur Werkstatt